This is default featured slide 1 title

Go to Blogger edit html and find these sentences.Now replace these sentences with your own descriptions.

This is default featured slide 2 title

Go to Blogger edit html and find these sentences.Now replace these sentences with your own descriptions.

This is default featured slide 3 title

Go to Blogger edit html and find these sentences.Now replace these sentences with your own descriptions.

This is default featured slide 4 title

Go to Blogger edit html and find these sentences.Now replace these sentences with your own descriptions.

This is default featured slide 5 title

Go to Blogger edit html and find these sentences.Now replace these sentences with your own descriptions.

Tampilkan postingan dengan label MATERI STATISTIKA EKONOMI 1 (UKURAN NILAI SENTRAL). Tampilkan semua postingan

6 Agustus 2013

PENGERTIA & JENIS TENDENSI SENTRAL

Pengertian dan Jenis Tendensi Sentral

Dalam tiga buku statistika terdapat berbagai macam penjabaran tentang tendensi sentral. Ada 3 macam pengertian tentang tendensi sentral dalam 3 buku yang berbeda ini.

1. Ukuran tendensi sentral atau ukuran gejala pusat adalah suatu ukuran yang digunakan untuk mengetahui ku mpulan data mengenai sampel atau populasi yang disajikan dalam tabel atau diagram yang dapat mewakili sampel atau populasi. Ada beberapa macam ukuran tendensi sentral, yaitu rata-rata (mean), median, modus, kuartil, desil dan presentil.
  • Rata-rata (mean)
Pengukuran rata-rata merupakan cara yang paling umum digunakan untuk mengukur nilai sentral suatu distribusi data berdasarkan nilai rata-rata yang dihitung dengan cara memebagi nilai hasil penjumlahan sekelompok data dengan jumlah data yang diteliti.
  • Median
Median adalah pengukuran tendensi sentral berdasarkan nilai data yang terletak ditengah-tengah (midpoint) dari suatu distribusi data penelitian yang disusun secara berurutan.
  • Modus
Modus mengukur tendensi sentral berdasarkan data yang memiliki frekuensi paling banyak dalam suatu distribusi data.

2. Tendensi sentral adalah jika kita melakukan pengamatan terhadap data sampel atau distribusi frekuensinya, maka kita akan memperoleh kesan bahwa sebagian besar data tersebut umumnya terdiri dari nilai-nilai observasi yang bertendensi untuk memusatkan diri sekitar suatu nilai tertentu. Adanya tendensi sentral semacam itu berarti bahwa suatu nilai sentral tertentu sebetulnya dapat digunakan untuk menggambarkan nilai-nilai keseluruhan data sampel itu sendiri.

3. Pengertian tendensi sentral yang ketiga adalah pengumpulan data maupun penyusunan data kedalam distribusi frekuensi tidak semata-mata dibutuhkan bagi tujuan yang sedemikian sederhananya itu. Analisa mengenai perbandingan antara dua kelompok hasil observasi, persoalan indeks, deret berkala, regresi dan sebagainya membutuhkan data untuk analisa yang bersifat lebih kompleks. Dalam hal sedemikian itu, pengumpulan data atau penyusunan data ke dalam distribusi frekuensi hanya merupakan tahap permulaan bagi analisa kuantitatif yang lebih lanjut.

Kesimpulan dari pengertian ketiga diatas adalah bahwa tendensi sentral merupakan pengumpulan data atau penyusunan data yang gunakan untuk menggambarkan nilai-nilai keseluruhan sampel dan populasi yang biasanya disajikan dalam bentuk diagram ataupun tabel yang hanya merupakan tahap permulaan bagi analisis kuantitatif.

24 Juli 2013

JENIS-JENIS UKURAN NILAI SENTRAL

Salah satu tugas dari statistic adalah mencari suatu angka disekitar mana nilai-nilai dalam suatu distribusi memusat. Angka yang menjadi pusat sesuatu distribusi disebut “tendensi sentral”.
Ada tiga macam tendesi sentral, yang sangat penting untuk dibicarakan disini. Ketiga tendensi sentral itu adalah:
A. MEAN
Adalah angka rata-rata. Dari segi aritmetik, Mean adalah jumlah nilai-nilai dibagi dengan jumlah individu.
Mean = X1 + X2 + X3 + … Xn-1 + Xn
Keterangan:
X1, X2 dan seterusnya adalah nilai-nilai individual
N = jumlah individu dalam distribusi
Σ dibaca  sigma  = jumlah
M  = Mean
M =  Σ X
           N

Contoh:
M = 15 + 10 + 20 / 3 =  45 / 3 =  15
1. MEAN yang ditimbang
Contoh : ada  4 orang berpenghasilan 10 rupiah
1 orang berpenghasilan 15 rupiah
1 orang berpenghasilan 20 rupiah, maka:
Penghasilan (X)
Frekuensi (f)
fX
20
15
10
1
1
4
20
15
40

N = 6
ΣfX = 75
M =  Σ fX       =  75 / 6 = 12,50
             N

2. MEAN dari distribusi bergolong
Rumusnya tida beda dengan distribusi tunggal, hanya saja nilai X disini tidak lagi mewakili nilai variabel individual, melainkan mewakili “titik tengah” interval kelas.
Contoh:
Interval nilai
Titik tengah (X)
f
fX
148 – 149
140 – 144
135 – 139
130 – 134
125 – 129
120 – 124
115 – 119
110 – 114
105 – 109
100 – 104
95 – 99
90 – 94
85 – 89
80 – 84
147
142
137
132
127
122
117
112
107
102
97
92
87
82
1
3
5
8
11
17
21
22
24
20
15
12
6
2
147
426
685
1056
1397
2074
2457
2464
2568
2040
1455
1104
522
164
Jumlah                                                                N = 167 ΣfX = 18559

M =  Σ fX      =  18559 /167 = 111,13
             N

3. MEAN dari distribusi bergolong dengan rumus terkaan
Istilah terkaan jangan diartikan raba-raba, sebab akhirnya kesalahan oleh terkaan itu dikoreksi kembali. Mean terkaan boleh juga disebut Mean Kerja, sebab Mean terkaan itu digunakan untuk pangkal bekerja.
Langkah-langkah untuk menghitung Mean dengan Mean terkaan  adalah sebagai berikut:
a.       Menerka sesuatu Mean Terkaan ini boleh semau kita
b.      Mencari deviasi nilai-nilai individual dari Mean terkaan itu. Deviasi-deviasi diatas mean terkaan diberi
          tanda plus, sedang dibawahnya diberi tanda minus
c.       Mengalikan deviasi tiap-tiap nilai itu dengan frekuensinya
d.      Menjumlahkan deviasi yang sudah dikalikan dengan frekuensi itu
e.       Mengisikan bahan-bahan yang sudah diperoleh itu kedalam rumus.
B. MEDIAN
Dapat dibatasi sebagai “ suatu nilai yang membatasi 50 persen frekuensi distribusi bagian bawah dengan 50 persen frekuensi distribusi bagian atas”.
Contoh:
Tabel Distribusi Penghasilan Fiktif Untuk Contoh Mencari Median
Individu
Penghasilan
1
2
3
4
5
6
7
Rp. 10
12
13
14
16
16
20

Medianya adalah  14, dimana individu nomor 4 membatasi separuh individu diatas dan separuh lagi dibawahnya.
1. Median Pada Distribusi Dengan Frekuensi Genap
Bilamana suatu distribusi mempunyai frekuensi genap, maka median dihitung secara kompromi, yaitu dengan membagi dua nilai-nilai variabel yang ada ditengah-tengah distribusi.
Misal : ada 4 orang, masing-masing punya tinggi badan 162, 162, 164 dan 166 cm,
Maka median tinggi badan empat orang itu adalah 163 (162 + 164 : 2 = 163 cm)
2. Mencari Median Dari Distribusi Bergolong
    Median = Bb +   1/2 N – cfb i
                                           fd
Keterangan:
Bb      :  batas bawah (nyata) dari interval yang mengandung median
cfb      :  frekuensi kumulatif (frekuensi meningkat) dibawah interval yang
             mengandung median
fd          : frekuensi dalam interval yang mengandung median
i          :  lebar interval
N       :  jumlah frekuensi dalam distribusi


C. MODE
Dapat dibatasi sebagai:
1.      Dalam distribusi tunggal ; nilai variabel yang mempunyai frekuensi tertinggi  dalam distribusi
2.      Dalam distribusi bergolong ; titik tengah interval kelas yang mempunyai frekuensi tertinggi dalam
         distribusi
Mode Dalam Distribusi Tunggal
Mode Dalam Distribusi Bergolong
KAPAN  PENGGUNAAN MEAN, MEDIAN, DAN MODE
1.      Waktu sangat terbatas, menggunakan mode
2.      Kejadian khusus yang membutuhkan mode
3.      Untuk perhitungan statistic selanjutnya, kita membutuhkan mean
4.      Adanya bahan-bahan yang hilang, Mean tidak dapat dihitung
5.      Distribusi sangat juling, melaporkan salah satu tendensi sentral member gambaran yang salah
6.      Dari segi stabilitas, Mean adalah tendensi sentral yang paling memuaskan

KESIMPULAN:
1. Mean biasanya dipilih orang sebagai pengukuran tendensi sentral, terutama bilamana distribusi mendekati
    normal, sebab Mean mempunyai stabilitas yang terbesar dan dapat digunakan sebagai dasar perhitungan
    statistic selanjutnya
2. Median adalah nilai variabel yang ditengah-tengah dan biasanya dipandang paling tepat untuk
     menggambarkan tendensi sentral bila distribusi menunjukkan “keistimewaan”, seperti sangat juling,
     adanya bahan-bahan yang tidak lengkap, dan semacamnya
3.  Mode rupa-rupanya menjadi suatu alat yang paling sederhana untuk menaksir tendensi sentral dalam
     keadaan tergesa-gesa, atau bilamana orang mencari keadaan-keadaan yang istimewa (seperti mode
     ukuran sepatu, dan semacamnya).

23 April 2013

NILAI SENTRAL

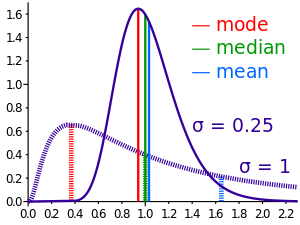
https://blogger.googleusercontent.com/img/b/R29vZ2xl/AVvXsEh0opdKeAN082_7_XKvQq-gpEqwefwqfIPWoAcAmBaCp7S5a_stcoxW2CR4gNzPJdGar9wuyj3ZBkrTPpwb8KmTUkRoXF1I2ByPemnvfaMyy0UFUah6NOhhZSJo-KENG4ckREZAFhP103gi/s1600/Comparison_mean_median_mode.svg.png


Nilai sentral atau nilai rata-rata juga disebut nilai tengah dari sekumpulan data statistik adalah suatu nilai dalam kumpulan atau rangkaian data yang dapat mewakili kumpulan atau rangkaian data tersebut.

Jenis-Jenis Nilai Sentral

1. Rata -rata hitung ( mean )
Mean adalah nilai rata-rata dari beberapa buah data. Nilai mean dapat ditentukan dengan membagi jumlah data dengan banyaknya data.
Mean (rata-rata) merupakan suatu ukuran pemusatan data. Mean suatu data juga merupakan statistik karena mampu menggambarkan bahwa data tersebut berada pada kisaran mean data tersebut. Mean tidak dapat digunakan sebagai ukuran pemusatan untuk jenis data nominal dan ordinal.
Berdasarkan definisi dari mean adalah jumlah seluruh data dibagi dengan banyaknya data. Dengan kata lain jika kita memiliki N data sebagai berikut maka mean data tersebut dapat kita tuliskan sebagai berikut:


Dimana:
x = data ke n
x bar = x rata-rata = nilai rata-rata sampel
n = banyaknya data
Bisa juga Menghitung mean

a) Rumus Mean Hitung dari Data Tunggal

 
b) Rumus Mean Hitung Untuk Data yang Disajikan Dalam Distribusi Frekuensi

Dengan : fixi = frekuensi untuk nilai xi yang bersesuaian
xi = data ke-i

c) Rumus Mean Hitung Gabungan


2. Median
Median menentukan letak tengah data setelah data disusun menurut urutan  nilainya. Bisa juga nilai tengah dari data-data yang terurut. Simbol untuk median adalah Me.  Dengan median Me, maka 50% dari banyak data nilainya paling tinggi sama dengan Me, dan 50% dari banyak data nilainya paling rendah sama dengan Me. Dalam  mencari median, dibedakan  untuk banyak data ganjil  dan banyak data genap.  Untuk  banyak data ganjil, setelah data disusun menurut nilainya, maka median Me adalah data yang terletak tepat di tengah. Median bisa dihitung menggunakan rumus sebagai berikut:
variansi merupakan salah satu ukuran sebaran yang paling sering digunakan dalam berbagai analisis statistika. Standar deviasi merupakan akar kuadrat positif dari variansi. Secara umum, variansi dirumuskun sabagai:
 

Contoh:
Dari lima kali kuiz statistika, seorang mahasiswa memperoleh nilai 82, 93, 86, 92, dan 79. Tentukan median populasi ini.

jawab:Setelah data disusun dari yang terkecil sampai terbesar, diperoleh  79 82 86 92 93
Oleh karena itu medianya adalah 86

Kadar nikotin yang berasal dari sebuah contoh acak enam batang rokok cap tertentu adalah 2.3, 2.7, 2.5, 2.9, 3.1, dan 1.9 miligram. Tentukan mediannya.

jawab:
Bila kadar nikotin itu diurutkan dari yang terkecil sampai terbesar, maka diperoleh 1.9 2.3 2.5 2.7 2.9 3.1
Maka mediannya adalah rata-rata dari 2.5 dan 2.7, yaitu 


Selain itu juga dapat dicari median dari data yang telah tersusun dalam bentuk distribusi frekuensi. Rumus yang digunakan ada dua, yaitu:
 

Dimana :
Bak = batas kelas atas median
c =  lebar kelas
s’ = selisih antara nomor frekuensi median dengan frekuensi kumulatif sampai kelas median
fM = frekuensi kelas median

Sebelum menggunakan kedua rumus di atas, terlebih dahulu harus ditentukan kelas yang menjadi kelas median. Kelas median adalah kelas yang memuat nomor frekuensi median, dan nomor frekuensi median ini ditentukan dengan membagi keseluruhan data dengan dua.


Secara singkat rumus median dapat digunakan sebagai berikut dalam perhitungan menggunakan tabel data


Keterangan:
Md : Nilai Median
L    : Tepi bawah dari kelas yang mengandung median
n    : Jumlah data
fc   : frekuensi komulatif pada kelas sebelum kelas median
fm  : frekuensi (absolut) dari kelas terdapatnya median
C   : Kelas interval

3. Modus

Modus adalah nilai yang sering muncul. Jika kita tertarik pada data frekuensi, jumlah dari suatu nilai dari kumpulan data, maka kita menggunakan modus. Modus sangat baik bila digunakan untuk data yang memiliki sekala kategorik yaitu nominal atau ordinal.
Sedangkan data ordinal adalah data kategorik yang bisa diurutkan, misalnya kita menanyakan kepada 100 orang tentang kebiasaan untuk mencuci kaki sebelum tidur, dengan pilihan jawaban: selalu (5), sering (4), kadang-kadang(3), jarang (2), tidak pernah (1). Apabila kita ingin melihat ukuran pemusatannya lebih baik menggunakan modus yaitu yaitu jawaban yang paling banyak dipilih, misalnya sering (2). Berarti sebagian besar orang dari 100 orang yang ditanyakan menjawab sering mencuci kaki sebelum tidur. Inilah cara menghitung modus:
  1.  Data yang belum dikelompokkan
    Modus dari data yang belum dikelompokkan adalah ukuran yang memiliki frekuensi tertinggi. Modus dilambangkan mo.
  2. Data yang telah dikelompokkan
    Rumus Modus dari data yang telah dikelompokkan dihitung dengan rumus:


Dengan : Mo = Modus

L = Tepi bawah kelas yang memiliki frekuensi tertinggi (kelas modus) i = Interval kelas
b1 = Frekuensi kelas modus dikurangi frekuensi kelas interval terdekat sebelumnya
b2 = frekuensi kelas modus dikurangi frekuensi kelas interval terdekat sesudahnya

Contoh:
Sumbangan dari warga Bogor pada hari Palang Merah Nasional tercatat sebagai berikut: Rp 9.000, Rp 10.000, Rp 5.000, Rp 9.000, Rp 9.000, Rp 7.000, Rp 8.000, Rp 6.000, Rp 10.000, Rp 11.000. Maka modusnya, yaitu nilai yang terjadi dengan frekuensi paling tinggi, adalah Rp 9.000.
Dari dua belas pelajar sekolah lanjutan tingkat atas yang diambil secara acak dicatat berapa kali mereka menonton film selama sebulan lalu. Data yang diperoleh adalah 2, 0, 3, 1, 2, 4, 2, 5, 4, 0, 1 dan 4. Dalam kasus ini terdapat dua modu, yaitu 2 dan 4, karena 2 dan 4 terdapat dengan frekuensi tertinggi. Distribusi demikian dikatakan bimodus. 


Standar Deviasi 

Standar Deviasi dan Varians Salah satu teknik statistik yg digunakan untuk menjelaskan homogenitas kelompok. Varians merupakan jumlah kuadrat semua deviasi nilai-nilai individual thd rata-rata kelompok. Sedangkan akar dari varians disebut dengan standar deviasi atau simpangan baku.
Standar Deviasi dan Varians Simpangan baku merupakan variasi sebaran data. Semakin kecil nilai sebarannya berarti variasi nilai data makin sama Jika sebarannya bernilai 0, maka nilai semua datanya adalah sama. Semakin besar nilai sebarannya berarti data semakin bervariasi.

Cara penulisan rumus fungsi standar deviasi:

STDEV (number1, number2,…)

Dengan:
Number1, number2, … adalah 1-255 argumen yang sesuai dengan sampel populasi. Anda juga dapat menggunakan array tunggal atau referensi ke array, bukan argumen yang dipisahkan oleh koma.
Keterangan
a. STDEV mengasumsikan bahwa argumen adalah contoh dari populasi. Jika data anda mewakili seluruh populasi, untuk menghitung deviasi standar menggunakan STDEVP.
b. Standar deviasi dihitung menggunakan metode “n-1″ .
c. Argumen dapat berupa nomor atau nama, array, atau referensi yang mengandung angka.
d. Nilai-nilai logis dan representasi teks dari nomor yang Anda ketik langsung ke daftar argumen akan dihitung.
e. Jika argumen adalah sebuah array atau referensi, hanya nomor/angka dalam array atau referensi yang akan dihitung. Sel kosong, nilai-nilai logis, teks, atau nilai-nilai kesalahan dalam array atau referensi akan diabaikan.
f. Argumen yang kesalahan nilai atau teks yang tidak dapat diterjemahkan ke dalam nomor/angka akan menyebabkan kesalahan. g. Jika Anda ingin memasukkan nilai-nilai logis dan representasi teks angka dalam referensi sebagai bagian dari perhitungan, gunakan fungsi STDEVA.
Dalam penerapannya STDEV , perhitungan standar deviasi secara manual menggunakan rumus berikut:


Dimana:
x = data ke n
x bar = x rata-rata = nilai rata-rata sampel
n = banyaknya data
variansi merupakan salah satu ukuran sebaran yang paling sering digunakan dalam berbagai analisis statistika. Standar deviasi merupakan akar kuadrat positif dari variansi. Secara umum, variansi dirumuskun sabagai :

Jika kita memiliki n observasi yaitu X1,X2,….Xn, dan diketahui Xbar adalah rata-rata sampel yang dimiliki, maka variansi dapat dihitung sebagai:


 Contoh:

Jika dimiliki data : 210, 340, 525, 450, 275
maka variansi dan standar deviasinya :
mean = (210, 340, 525, 450, 275)/5 = 360

variansi dan standar deviasi berturut-turut:


Sedangkan jika data disajikan dalam tabel distribusi frekuensi, variansi sampel dapat dihitung sebagai: